Hoje em dia, o gerente de manutenção que está avaliando softwares de manutenção preditiva com IA enfrenta uma conversa que mudou muito nos últimos dois anos. Em 2023, encontrar um fornecedor que oferecesse IA era diferencial. Agora todos vendem IA, da plataforma madura ao sensor que envia dado para um dashboard genérico.
A dificuldade deixou de ser encontrar IA, e passou a ser encontrar aquela que gera decisões mais inteligentes em vez de apenas mais alertas.
Essa separação não é óbvia na demonstração de venda. Um fornecedor com dashboard bonito e discurso bem ensaiado pode travar na primeira semana de piloto na sua planta. Por outro lado, um fornecedor com interface mais simples pode entregar o diagnóstico que o seu time usa no dia seguinte.
Neste artigo, você vai ver qual é a eficácia real das plataformas de manutenção preditiva com IA, as quatro camadas que o software precisa cobrir para gerar retorno, o que separa a IA útil da IA de dashboard, os erros mais comuns na aquisição e como fazer um piloto de 90 dias que de fato mostra o que importa.
Leia também:
- Indústria 5.0: Como o monitoramento multimodal vai redefinir o mercado
- IA multimodal na manutenção industrial: vantagens de cruzar sinais
- Monitoramento multimodal x tradicional: diferenças e benefícios
Qual a eficácia de plataformas de manutenção preditiva com IA
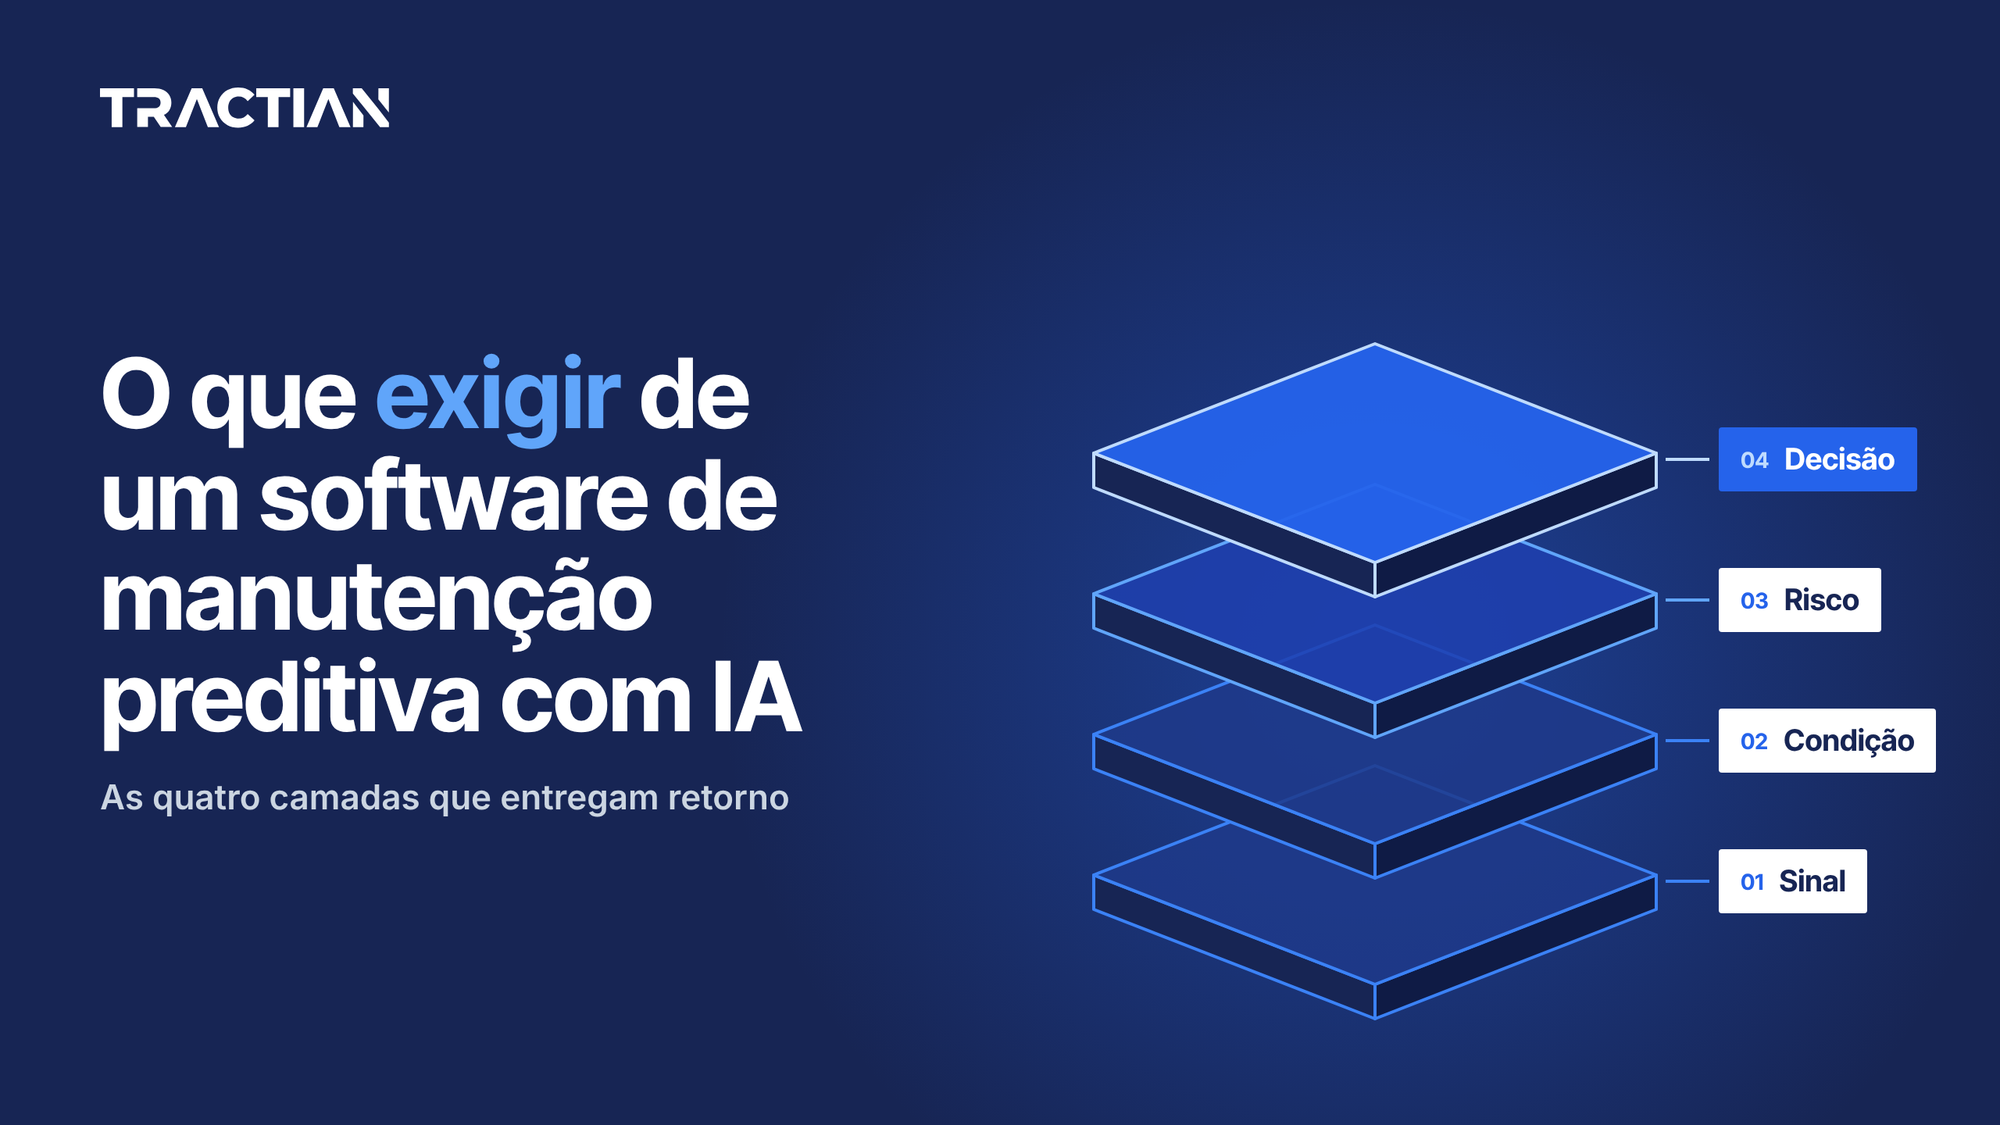
A eficácia real de um software de manutenção preditiva com IA depende de quatro camadas operando juntas: a captura do sinal no ativo, a análise da condição pela IA, a priorização por risco de falha e a conversão em decisão executável no CMMS.
Quando qualquer uma dessas camadas está fraca ou ausente, o retorno cai, mesmo que a IA em si seja boa.
Por isso, é comum que a tentação ao avaliar um fornecedor de software de manutenção preditiva seja olhar só para a IA. É a camada mais nova, a mais barulhenta na feira, a que mais aparece no material comercial. Mas a IA é o meio do stack, não a ponta.
Se a camada de sinal chega incompleta, com sensores que capturam vibração em um instante e temperatura em outro, a IA interpreta dados inconsistentes e gera diagnósticos fracos e pouco confiáveis.
A eficácia só aparece quando as quatro camadas sustentam umas às outras. O sinal multimodal confiável alimenta IA que gera diagnóstico confiável. O diagnóstico confiável prioriza o backlog. O backlog priorizado vira ação no CMMS que o time já usa. E qualquer corte nessa cadeia reduz o retorno proporcionalmente.
Quatro camadas que um software de manutenção preditiva com IA precisa cobrir
As quatro camadas que um software de manutenção preditiva com IA precisa cobrir são: sinal (multimodalidade sincronizada no mesmo ponto físico), condição (linha de base individual aprendida por ativo), risco (priorização por probabilidade de falha funcional) e decisão (alerta nascendo como ordem de serviço no CMMS que a planta já usa).
Cada uma resolve um problema específico e, juntas, formam o stack que entrega retorno.
Cobertura por camada do stack
Fornecedor completo vs. fornecedor parcial
Qual camada cada perfil de fornecedor entrega — e qual trava o retorno quando falta.
Sinal
Multimodalidade sincronizada
Condição
Baseline individual por ativo
Risco
Priorização por probabilidade de falha
Decisão
Integração nativa com CMMS
Camadas cobertas
Camada de sinal: multimodalidade sincronizada no mesmo ponto físico
A camada de sinal resolve a dor do dado parcial. Um fornecedor que entrega sensores diferentes em pontos diferentes e cruza tudo depois gera um “multimodal” que, na prática, é só a sobreposição de leituras desconectadas no tempo.
O que resolve é o sensor que captura vibração, ultrassom, temperatura e RPM no mesmo chip, no mesmo instante, com timestamp compartilhado. É essa sincronia que viabiliza o diagnóstico cruzado e, sem ela, a camada superior já começa comprometida.
Camada de condição: linha de base individual por ativo, não threshold fixo
A camada de condição é onde o threshold fixo da geração anterior mais claramente trava. Um ativo com regime variável gera alerta toda vez que muda de carga, e o time aprende a filtrar manualmente. A baseline individual elimina esse ruído: a IA observa o ativo nas primeiras semanas, aprende como ele se comporta em cada regime e passa a avaliá-lo contra ele mesmo.
Camada de risco: priorização por probabilidade de falha funcional
A camada de risco resolve a dor do backlog plano. Sem ela, todos os alertas chegam com o mesmo peso, e o time precisa decidir ordem de prioridade com base em opinião. Com ela, a IA calcula a probabilidade de falha funcional de cada ativo monitorado e ordena o backlog por risco financeiro real. Para o gerente de manutenção, isso resolve a conversa mais difícil do planejamento: o que fazer primeiro quando o headcount não cobre tudo.
Camada de decisão: alerta virando ordem de serviço com procedimento e sobressalente vinculados
A camada de decisão fecha o ciclo. O alerta não para no dashboard. Em vez disso, vira ordem de serviço no CMMS que a planta já usa, com modo de falha nomeado, procedimento preventivo vinculado e sobressalente indicado. O técnico chega no ativo com o roteiro pronto. A dor histórica de “alerta sem contexto, OS aberta com atraso, intervenção fora de janela” desaparece quando essa camada funciona de verdade.
O que separa a IA útil da IA de dashboard
A IA útil se diferencia em três dimensões: nomeia o modo de falha específico em vez de alertar sobre anomalia genérica, aprende continuamente com o retorno do técnico em campo e é respaldada por suporte humano especializado nos casos de alto impacto.
Qualquer uma das três faltando transforma a plataforma em um dashboard caro com nome chique, mas com pouco efeito prático no universo industrial.
Diagnóstico amarrado ao modo de falha
Alerta de “vibração acima do limite” não é diagnóstico. É só a evidência de que algo mudou, mas fica apenas nisso. Para o técnico agir, ele ainda precisa descer no espectro, cruzar com temperatura, confirmar com inspeção visual.
Uma IA funcional elimina esse passo intermediário. O alerta chega com o modo nomeado: “assinatura compatível com defeito em pista externa de rolamento, estágio incipiente, janela estimada de 4 a 6 semanas”.
O técnico só precisa validar uma hipótese pronta em vez de abrir a investigação do zero.
Na ICONIC, isso é literalmente o que Bruno Ribeiro, Gerente Industrial, destacou como diferença operacional: receber a causa provável junto com o alerta transformou a rotina do time, que deixou de reagir ao sinal e passou a decidir com o diagnóstico já encaminhado.
Aprendizado por reforço com retorno do técnico ajustando o modelo
A IA de dashboard é estática, entrega sempre a mesma resposta e com os mesmos erros. IA útil incorpora o feedback do técnico em campo: cada diagnóstico validado ou corrigido volta para o modelo e refina a baseline do ativo e a base global. Com o tempo, o sistema erra menos naquela máquina específica, naquele modo de falha específico.
Pergunte ao fornecedor como o aprendizado por reforço funciona na prática. Se a resposta for genérica, o modelo é estático.
Suporte humano especializado em caso de alto impacto
Um dashboard sem suporte humano é uma plataforma incompleta. A IA resolve a maior parte dos casos, mas o alerta que aparece uma vez a cada seis meses em ativo crítico sem histórico de falha precisa de alguém que já viu aquela assinatura antes. Um fornecedor sério oferece engenheiros de confiabilidade disponíveis no contrato, em fuso compatível com a operação. É o combo que junta tecnologia e pessoas, lado a lado, e é o que sustenta confiabilidade de longo prazo.
Erros comuns na aquisição de software de manutenção preditiva com IA
Os quatro erros mais comuns na aquisição de software de manutenção preditiva com IA são: comprar sensor sem IA integrada e tentar costurar depois, aceitar demonstração em ativo genérico em vez de piloto na própria planta, subestimar a curva de adoção da equipe técnica e ignorar o fuso horário do suporte técnico.
Qualquer um dos quatro pode travar o retorno em menos de seis meses.
Comprar sensor sem IA integrada e tentar costurar depois. A tentação é comprar o hardware mais barato e contratar IA como serviço separado. Isso vira projeto de integração, com fornecedores de hardware, software e CMMS em contratos diferentes. Cada interface vira ponto de falha. O retorno estimado some entre problemas de responsabilidade cruzada. E o fornecedor que entrega o stack sob um único contrato elimina essa fricção desde o começo.
Aceitar demonstração em ativo genérico em vez de piloto na própria planta. Demonstração no ativo do fornecedor serve para entender a interface, e não para avaliar se a plataforma vai funcionar nos seus ativos, com os seus modos de falha, no seu regime de operação. Peça um piloto na sua planta, em ativos que você escolhe, pelo tempo suficiente para a baseline individual se formar (de 4 a 12 semanas, dependendo do ativo).
Subestimar a curva de adoção da equipe técnica. A tecnologia é instalada em dias, mas a adoção pelo time leva meses. Se o fornecedor não oferece suporte estruturado para a transição, incluindo treinamento, acompanhamento de uso e ajuste de workflow, isso vai ficar sob sua responsabilidade. E normalmente isso só gera mais dor de cabeça com o time de manutenção.
Ignorar o fuso horário do suporte técnico. Fornecedor sediado em região com diferença de fuso de 6 ou 12 horas em relação à sua planta oferece suporte que chega tarde demais para o alerta crítico. Pergunte onde fica o time de suporte, qual é o horário de atendimento, qual é o SLA para caso urgente. Se a resposta for genérica, você vai descobrir isso no primeiro incidente real.
Como estruturar o piloto
Plano de 90 dias para avaliar manutenção preditiva com IA
Critérios de aceite combinados antes do dia 1, não no fim do piloto.
-
Dias 1 a 30
Cobertura e configuração
- Instalação dos sensores nos ativos escolhidos
- Configuração da integração com o CMMS
- Início do aprendizado da baseline individual
- Treinamento inicial do time
-
Dias 31 a 60
Utilidade do diagnóstico e fluxo
- Avaliação dos alertas gerados
- Validação em campo dos primeiros diagnósticos
- Passagem de alerta para OS no CMMS
- Ajuste de workflow conforme uso real
-
Dias 61 a 90
Repetibilidade e decisão
- Avaliação da taxa de falso positivo
- Tempo médio da plataforma ao técnico em campo
- Consistência dos diagnósticos em diferentes regimes
- Decisão de escala com dados do piloto
Na prática
A ICONIC chegou a 63% da planta monitorada em menos de três meses de implementação.
Como o monitoramento multimodal da Tractian entrega manutenção preditiva com IA
A arquitetura descrita aqui é a que a plataforma de saúde de ativos da Tractian entrega hoje, com as quatro camadas cobertas.
Na camada de sinal, nosso sensor multimodal captura vibração triaxial, ultrassom, temperatura e RPM em sincronia, no mesmo chip. Na camada de condição, a IA treinada no nosso AI Center, onde quebramos as nossas máquinas para que as suas nunca precisem quebrar, aprende a baseline individual de cada ativo e cruza os sinais contra a base instalada global que acumulamos em milhares de plantas.
Na camada de risco, o backlog é ordenado por probabilidade de falha funcional, não por ordem de chegada do alerta. E na camada de decisão, o alerta vira ordem de serviço direto no CMMS que a sua planta já usa, com modo de falha nomeado, janela estimada de intervenção e procedimento vinculado.
Quer ver na prática como isso funciona na sua planta?