Toda planta com ativo crítico opera hoje sob a mesma tensão: o cronograma de manutenção mecânica raramente sobrevive ao mês inteiro. Afinal, o grande problema com esses ativos é justamente sua imprevisibilidade, o potencial de paradas inesperadas bem quando menos podemos parar.
A causa costuma ter origem em um problema comum: o fato de existir uma janela cega de três a quatro semanas entre uma rota mensal e a próxima. É justamente nesse momento, sem ser capaz de visualizar o que está acontecendo, que o defeito pode ter seu início e seu time nem saber. Assim, quando a nova coleta chega, ou o defeito já está estruturado e a manutenção precisa ser corretiva emergencial.
Isso gera diversas questões, seja um backlog que cresce com velocidade dobrada ou a falta de um handoff qualificado entre turnos ou, é claro, o cronograma de manutenção que se perde mês a mês, restando apenas intervenções corretivas.
O que a manutenção mecânica industrial em ativo crítico precisa hoje em dia é de dado contínuo, não como sofisticação técnica, mas como uma resposta operacional às limitações práticas da rota manual.
Neste artigo, você vai ver por que a rota mensal não sustenta mais plantas com ativos críticos, o que muda na rotina do time quando o dado chega antes da falha e quais sensores fazem sentido para essa arquitetura.
Leia também:
- Plataforma de Asset Condition: como o sensor multimodal cruza sinais
- Sincronização entre sensores: como a IA multimodal garante isso
- Inteligência Artificial na indústria: o que avaliar antes de comprar
Por que a manutenção mecânica industrial em ativo crítico não se sustenta com rota mensal
Porque a rota mensal foi construída para uma realidade em que o time tinha tempo de sobra para investigar cada alerta gerado pela coleta. Conforme a indústria brasileira e global passou a pedir mais entregas, e com mais velocidade e urgência, essa realidade sumiu.
Você já deve ter visto todas na prática, mas a verdade é que existem três limitações estruturais que fazem a rota perder mensal perder o sentido:
Intervalo entre coletas maior que a janela P-F típica do ativo
A janela entre o ponto em que a falha começa a emitir sinal detectável (P) e o ponto em que ela vira uma falha funcional (F) varia por classe de ativo. Por exemplo, em rolamentos de motor e em vedação de bombas a periodicidade costuma ficar entre 4 e 8 semanas.
Na rota mensal, a verificação acontece a cada 30 dias. Ou seja, a coleta acontece apenas perto do ponto F da curva, quando o defeito já está estruturado, e não perto de P, quando a intervenção ainda cabe em manutenção programada.
O que isso significa? Falha que pode comprometer o pleno funcionamento da planta.
Backlog crescente entre confiabilidade e execução de OS
Cada rota gera hipóteses técnicas que precisam ser investigadas em campo. Se o time de execução recebe 40 hipóteses por mês e tem capacidade de investigar 25, a matemática é simples: o backlog cresce mês a mês.Isso significa que um alerta gerado em janeiro, em vez de entrar em uma lógica de priorização automatizada, entra na fila de espera e o defeito continua evoluindo.
Então, quando o técnico finalmente vai ao ativo alguns meses depois, o achado é uma falha em curso, e não mais uma degradação incipiente.
Priorização por ordem de chegada em vez de severidade real
Sem dados contínuos entre coletas, os gerentes de planta precisam priorizar o backlog pela data em que o alerta foi gerado. Portanto, um ativo que apareceu no relatório de janeiro entra antes de ativos que apareceram em fevereiro. Mas quem entrou primeiro na fila nem sempre é quem vai falhar primeiro, e o time acaba investindo hora de técnico em ativo estável enquanto o ativo que gritou depois estava, na verdade, mais perto de quebrar.
O que muda na rotina do time quando a manutenção mecânica ganha dados de condição contínuos
Com os dados de condição contínuos em mãos, o time de manutenção é capaz de antecipar as falhas dos ativos críticos, dispensar a visita aos ambientes mais rigorosos e perigosos da operação e ainda tem um backlog menor, porque os alertas são mais assertivos.
Veja como isso acontece nas plantas industriais brasileiras que já contam com monitoramento contínuo:
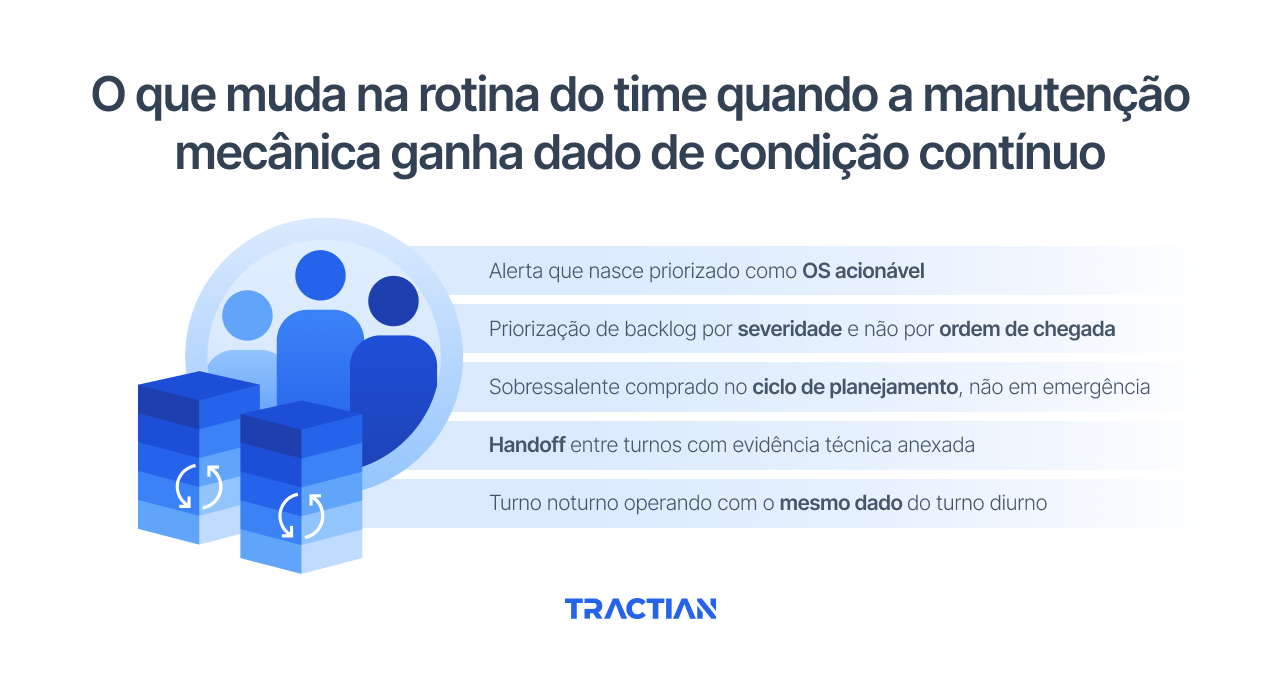
Alerta que nasce priorizado como OS acionável
O alerta deixa de chegar como sinal técnico bruto, daquele tipo que exige triagem logo na reunião de segunda-feira. Em vez disso, nasce já com criticidade calculada, hipótese de modo de falha nomeada, e prazo até a próxima janela de produção disponível. Depois, entra no backlog na posição que corresponde à severidade real, e a reunião de priorização se torna só um momento de validação, não construção do zero.
Priorização de backlog por severidade e não por ordem de chegada
Backlog reorganizado por risco muda tudo para os gerentes de plantas. Isso porque as ordens de serviço que estavam há semanas no topo da lista de prioridades podem até acabar descendo, afinal, com os dados reais e completos do ativo, é muito comum perceber que o tempo de usa pode não significar nada em relação às falhas.
Lembre-se que ativos críticos têm alta variabilidade no tempo de uso antes de uma falha incipiente. Por isso, muitas operações acabam vendo outras ordens de serviço subindo na lista, porque a priorização do backlog passa a ser feita por severidade. Isso protege seus ativos de trocas desnecessárias e também te impede de lidar com uma deterioração mais grave do ativo — coisa que a coleta mensal impossibilita.
Sobressalente comprado no ciclo de planejamento, não em emergência
Com o dados contínuos, a detecção pode acontecer com até 6 semanas de antecedência e isso muda tudo no modo de compra. O sobressalente passa a ser comprado no ciclo normal de aquisição, com prazo de fornecedor, condição de pagamento, frete regular. Compra em regime de urgência, com preço elevado e frete emergencial, deixa de ser parte da realidade e se torna uma mera exceção.
Handoff entre turnos com evidência técnica anexada
Agora, com dados, os handoffs entre turnos não são só relatórios escritos com base em alguns palpites. Não, a evidência acompanha a ordem de serviço e sustenta a hipótese, seja espectro de vibração, deriva térmica ou contexto operacional do ativo no momento do desvio. O técnico do turno seguinte não precisa começar a intervenção reconstruindo o raciocínio do turno anterior, mas só prossegue a partir do ponto em que o outro técnico estava.
Isso significa: mais eficiência, mais agilidade na troca de peças e mais organização em relação aos ativos de toda a operação.
Quais sensores de vibração usar na manutenção mecânica industrial
Os melhores sensores de vibração para máquinas industriais são aqueles que combinam cobertura ampla de frequência (para captar defeitos em ativos lento e bandas de rolamento em ativos rápidos), captura triaxial (para separar assinatura axial, radial horizontal e radial vertical), e transmissão contínua. Tudo isso dentro de uma plataforma central, que processa esses dados automaticamente.
Esses fatores garantem os dois maiores benefícios que plantas fabris devem buscar quando se trata de manutenção industrial: qualidade do sinal capturado e integração com o fluxo de manutenção que já existe na planta.
Do lado do sinal, sampling rate na faixa de dezenas de kHz é o mínimo para resolver bandas de defeito de rolamento em ativo de alta rotação, e cobertura de baixa frequência (fração de Hz) é o mínimo para ativos mais lentos.
Do lado da integração, o ideal é trabalhar com uma plataforma que centralize todos os dados, que facilite a vida do técnico de manutenção e que otimize a economia da planta — aquilo que a indústria chama, hoje em dia, de plataforma multimodal.
Como a plataforma da Tractian garante manutenção mecânica industrial contínua
Toda arquitetura descrita acima só entrega valor se três coisas acontecerem em conjunto: o sensor capturar o sinal certo em cada ponto, a IA distinguir defeito de variação normal do ativo, e o alerta chegar no fluxo de OS do time sem virar parte de uma rotina paralela.
É exatamente esse conjunto que a Tractian entrega como plataforma unificada de Asset Condition.
Nosso sensor multimodal cobre as quatro dimensões da falha em ativos rotativos (vibração triaxial em faixa ampla, ultrassom, temperatura de superfície e RPM real) em um único dispositivo, sem fio, com fixação magnética.
E a instalação demora alguns minutos por ponto de coleta.
Não é um sensor de vibração com feature secundária de temperatura ou com módulo de ultrassom vendido à parte. É uma captura sincronizada dos quatro sinais no mesmo instante, o que resolve o passo de cobertura por criticidade sem precisar montar arquitetura de vários fornecedores no mesmo ativo.
Todos esses dados são processados pela nossa IA, desenvolvida internamente no AI Center, um espaço dedicado ao aprimoramento de inteligências artificiais industriais. Lá, essa IA evolui a cada histórico criado pelos ativos que testamos. Como isso acontece? Quebramos nossas máquinas para que as suas nunca precisem quebrar.
Na sua planta, o alerta de alguma falha chega para o seu time já com o modo de falha nomeado, aprendizado veloz em relação ao histórico do próprio ativo e com OS automatizada no fluxo do time — já com criticidade calculada, procedimento vinculado e sobressalente indicado.
Quer ver como funciona na prática?
Fale hoje com a Tractian e melhore a eficiência e segurança dos seus ativos críticos com uma plataforma que mostra toda a saúde das suas máquinas.